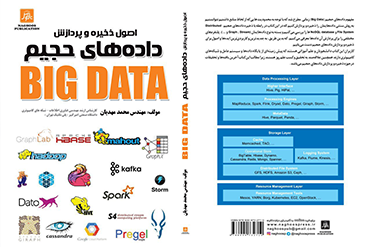
مفهوم دادههاي حجيم (Big Data) زماني مطرح شد كه دادههايمان را نتوانستيم ذخيره و پردازش كنيم و با عنايت به اينكه دادههاي حجيم (Big Data) فقط ديتا هستند كه تنها حجم و يك سري مشخصاتشان تغيير كرده است و با توجه به محدوديتهايي كه از لحاظ Resource داريم نميتوانيم با استفاده از روش هاي سنتي، ديتا را ذخيره و تحليل كنيم پس به يك راه و يك بستر جديد براي ذخيره و تحليل اين ديتا احتياج داريم. طبيعتا اين نياز در بعضي شركت ها مثل Google كه دادههاي بيشتري داشتند بيشتر احساس شد.
در رابطه با دادههاي حجيم سه سوال اصلي پيش روي ما قرار دارد و در اين كتاب سعي ميكنيم آنها را بررسي كنيم كه اين سوالات به شرح زير مي باشند:
1-چگونه دادههاي حجيم را ذخيره (Store) كنيم؟ ذخيره سازي دادهها اولين مسئله اي است كه بايد آن را بررسي كنيم که در این رابطه Distributed File System وNoSQL database ها را معرفی و بررسي ميكنيم.
2-چگونه دادههاي حجيم را پردازش (Process) كنيم؟ حال بسته به اینکه دادههای ما از چه جنسی باشند Platformهای مختلفی را معرفی ميكنيم. مثلا اگر دادهها ما ثابت غیر قابل تغییر باشند و اگر همه دادهها را یکجا داشته باشیم ازBatch Processing Platform استفاده ميكنيم و اگر دادههایStream (جاري) داشته باشیم از Platform Streaming Processing استفاده ميكنيم و اگر دادهها ساختاریافته باشند میتوانيم از Platformهایی مثل Spark SQL یا … استفاده کنیم و اگر دادهها از جنس گراف باشند ازGraph Platform استفاده ميكنيم.
3-اگر قرار باشد يك Cluster از كامپيوتر ها داشته باشيم، چگونه منابعي كه بين كامپيوترهاي یکCluster توزيع شده را مديريت كنيم؟ در واقع اگر قرار باشد هرکدام از Platformهاي بالا روی یکCluster نصب و اجرا شوند، چگونه آن منابع را به اين Platformها تخصیص دهیم كه در اين رابطه Messos را بررسي مي كنيم.
براي گسترش و فراگير شدن مفهوم دادههاي حجيم و بسترهاي ذخيره و پردازشي آن، بستر Cloud Computing و Communityهاي OpenSource نقش مهمي دارند و منابعي كه توسط Cloud در اختيار ما قرار داده شده است اين امكان را به ما ميدهد كه بتوانيم بسترهاي ذخيره و پردازشي دادههاي حجيم را راحت تر Deploy كنيم.
در این کتاب در رابطه با ذخيره دادههاي حجيم، Distributed File System وNoSQL database ها بررسي ميكنيم و بسته به نوع دادههایمان (Stream، Graph و…)، پلتفرمهای مختلفی را برای پردازش آن دادهها معرفی ميكنيم که بدین طریق، به جدیدترین و كاربرديترين ایدهها و اصول برای ذخيره و پردازش دادههاي حجيم دست مییابیم.
کاربران این کتاب دانشجویان و علم آموزانی هستند که پیش زمینهای از پایگاه دادهها و سیستم عامل و شبکههای کامپیوتری دارند همچنین علاقهمند به تحقیق و کسب علم روز هستند زیرا مطالب این کتاب آخرین یافتهها و تحقیقات در حوزه ذخيره و پردازش دادههاي حجيم میباشد.
http://opac.nlai.ir/opac-prod/bibliographic/6123588